Technické SEO je všechno, co rozhoduje o tom, jestli Google váš web najde, projde, načte a pochopí. Většinu z toho zkontrolujete sami v bezplatných nástrojích Googlu, hlavně v Search Console a v PageSpeed Insights.
Níže je seznam deseti kontrol, k nim postup, jak ověřit indexaci, a tři chyby, které jsem v říjnu 2026 našla na vlastním webu.
Co je technické SEO a čím se liší od obsahu a odkazů
SEO má tři části a technika je ta první:
- Technika: Google se ke stránce dostane, načte ji celou a zařadí ji do indexu, tedy do seznamu stránek, ze kterých vybírá výsledky.
- Obsah: stránka odpovídá na to, co lidé hledají, líp než stránky konkurence.
- Odkazy a důvěra: o vás píšou jiné weby, máte recenze a Firemní profil na Googlu.
Technika je podmínka, ne důvod, proč vás Google ukáže vysoko. Stránku, kterou Google nenačte, neukáže správně. Technicky bezvadnou stránku, která nikomu neodpovídá, ale taky neukáže vysoko.
Kontrolní seznam: 10 věcí, které zkontrolujete sami
| Co zkontrolovat | Kde to uvidíte | V pořádku je | Když ne |
|---|---|---|---|
| 1. Indexace | Search Console → Indexování → Stránky; u jedné stránky Kontrola adresy URL | stránky služeb, produktů a kontaktu jsou zelené (indexované) | postup níže v sekci o indexaci; víc v článku proč Google nezobrazuje vaše stránky |
| 2. Sitemapa | vasedomena.cz/sitemap.xml a Search Console → Soubory Sitemap | Search Console ji načetla bez chyby a jsou v ní jen stránky, které chcete ve vyhledávání | jak sitemapa funguje, pro Bing a Seznam můžete nové stránky hlásit přes IndexNow (Google ho nepoužívá) |
| 3. Robots.txt | vasedomena.cz/robots.txt | neblokuje stránky, které mají být v Googlu, ani soubory CSS a JS | řádek Disallow: / zakazuje procházet celý web; jak robots.txt číst |
| 4. Zákaz indexace (noindex) | Kontrola adresy URL u důležitých stránek | žádná důležitá stránka nemá noindex | noindex často zůstane zapnutý po vývoji webu. Robots.txt stránku z Googlu neodstraní, k tomu slouží noindex. Stránka s noindexem přitom nesmí být blokovaná v robots.txt, jinak ho Google nepřečte; kdy noindex použít a kdy ne |
| 5. Přesměrování | kontrola přesměrování: zadejte web s www i bez, s http i https | všechny čtyři varianty skončí na jedné adrese jedním skokem | stará adresa bez přesměrování ztratí, co si u Googlu vybudovala; 301 přesměrování |
| 6. Duplicity a canonical | Search Console → Stránky, stavy „Duplicitní…“ | každá stránka existuje pod jednou adresou, filtry a parametry ukazují na hlavní verzi | značka canonical a parametry v adresách |
| 7. Rychlost a Core Web Vitals | PageSpeed Insights na mobilu; Search Console → Přehled Core Web Vitals (u malých webů bývá prázdný) | hlavní obsah do 2,5 s, nic neposkakuje | sekce o Core Web Vitals níže |
| 8. Mobil | váš telefon a Kontrola adresy URL | text čitelný bez přibližování, tlačítka jdou trefit prstem, formulář se dá odeslat | Google indexuje mobilní verzi webu; co z toho plyne |
| 9. HTTPS | adresní řádek prohlížeče | zámek, žádné „Nezabezpečeno“, certifikát platný | certifikát nastavuje hosting; HTTPS a SSL |
| 10. Rozbité odkazy a stránky bez odkazu | Search Console → Stránky, stav „Nenalezeno (404)“; crawler, například Screaming Frog | odkazy nevedou na 404 a na každou důležitou stránku vede odkaz z jiné stránky webu | interní prolinkování |
Strukturovaná data do seznamu nepatří jako kontrola „musí být“. Web bez nich funguje. Když je ale máte, otestujte je v Rich Results Test od Googlu. Chybná data Google nepoužije, klamavá mu vadí. Víc o nich v článcích o strukturovaných datech pro e-shopy a LocalBusiness pro místní firmy.
Dvě věci, které ve starších návodech pořád najdete a už neplatí: rozšířené výsledky s návodem krok za krokem (HowTo) Google od září 2023 neukazuje a výsledky s otázkami a odpověďmi (FAQ) od 7. května 2026 taky ne. Značky FAQ na webu nevadí, ale do výsledků vyhledávání vám už nic nepřidají.
Jak zkontrolovat indexaci webu v Googlu
Nejspolehlivěji v Google Search Console. Pokud ji ještě nemáte, založíte ji a ověříte, že web patří vám.
- Indexování → Stránky. Nahoře je počet indexovaných a neindexovaných stránek, pod tím důvody, proč Google stránky do indexu nezařadil.
- Kontrola adresy URL. Do horního pole vložte adresu stránky služby nebo produktu. Uvidíte, jestli je v indexu, kdy ji Google naposledy procházel a jakou adresu považuje za hlavní.
- Požádat o indexování. Tlačítko je v Kontrole adresy URL. Použijte ho u stránky, kterou jste opravili nebo nově vydali.
Dva stavy matou nejčastěji:
- Procházeno - momentálně neindexováno: Google stránku viděl a do indexu ji nezařadil. Podle nápovědy Search Console ji není potřeba znovu odesílat. Obvykle nejde o technickou chybu, ale o stránku, kterou Google nepovažuje za dost užitečnou, nebo o téměř stejnou stránku, jakou na webu už máte.
- Objeveno - momentálně neindexováno: Google o stránce ví, ale ještě ji neprošel.
Google sám píše, že nemáte čekat zaindexování každé adresy webu. Důležité je, aby v indexu byly stránky, přes které k vám chodí zákazníci. Když jich ve stavu Procházeno - momentálně neindexováno vidíte desítky, technická oprava je nevrátí. U každé rozhodněte, jestli ji přepsat, sloučit s podobnou, zrušit, nebo na ni posílit odkazy z webu.
Co jsem našla na vlastním webu
20. října 2026 jsem prošla technický stav webu seopohotovost.cz: crawlerem všech 383 adres ze sitemapy, každou adresu v Kontrole adresy URL v Search Console, rychlost v PageSpeed Insights a vybrané stránky v Chromu na šířce telefonu.
1. Stará kopie stránek v cache: 103 stránek se nenačetlo celých
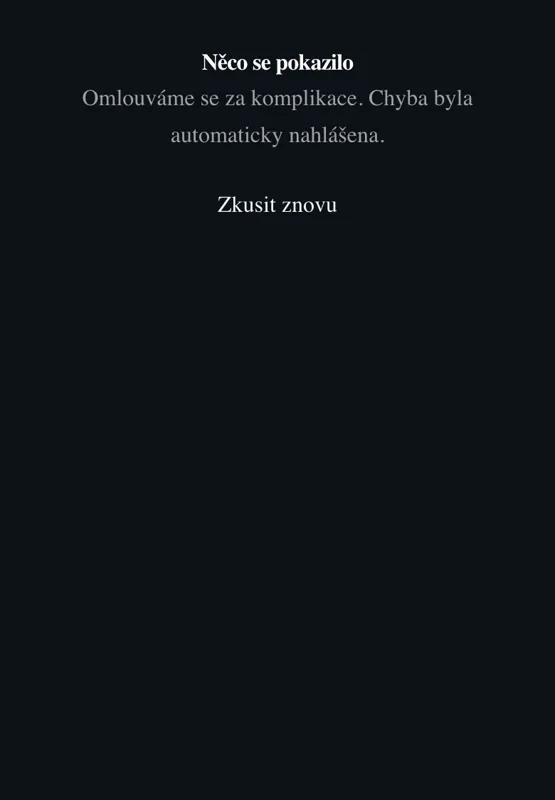
Jak se to projevilo: stránka otevřená z výsledků Googlu se nenačetla celá. Některé články se ukázaly jako holý text bez vzhledu a ceník, kontakt a stránky služeb místo obsahu ukazovaly jen „Něco se pokazilo“.
Jak jsem to našla: crawler u každé ze 383 stránek ověřil, jestli existují soubory se vzhledem a skripty, na které stránka odkazuje. U 103 stránek (27 %) některý chyběl.
Co to znamenalo: web běží přes Cloudflare, službu, která uložené kopie stránek doručuje rychleji. Kopie se mohly držet až rok. Nová verze webu mezitím smazala staré soubory, na které uložené kopie odkazovaly. Z odkazu na Facebooku se přitom stránka načetla správně: ten odkaz nese v adrese parametr, takže pro Cloudflare je to jiná adresa a stránka přijde čerstvá. Kdo otevřel čistou adresu, z Googlu, ze záložky nebo napsanou ručně, dostal starou kopii. Rozbitou stránku mohl vidět i Googlebot.
Jak se to opravilo: po každém nasazení nové verze se teď uložené kopie smažou celé. A když stránce přesto chybí soubor, sama se jednou znovu načte z čerstvé adresy.
Co si z toho vzít: web zkoušejte tak, jak na něj přichází zákazník. Z výsledků Googlu, v anonymním okně, na mobilu. A po každé změně webu, i po té, kterou dělá automat: tuhle chybu spustila automatická týdenní aktualizace.
2. Starší články schované za tlačítkem „Načíst další“
Jak jsem to našla: crawler spočítá, kolik odkazů vede na každou stránku. Blog a každá kategorie ukazovaly odkazy jen na 12 nejnovějších článků. Na zbytek vedlo tlačítko „Načíst další články“, které články dotahovalo skriptem. 28 stránek ze sitemapy nemělo z webu jediný odkaz. V kategorii Technické SEO vedl z kategorie odkaz jen na 12 z 61 článků.
Co to znamenalo: roboti Googlu podle jeho dokumentace na tlačítka neklikají. Část starších článků (28) mohl Google najít jen v sitemapě, bez odkazu z vlastního webu. A odkaz z vlastního webu je pro Google signál, že stránka k něčemu je.
Jak se to opravilo: tlačítko je teď obyčejný odkaz na další stránku blogu (/blog?page=2). Návštěvník nepozná rozdíl, Google odkaz projde.
Co si z toho vzít: máte na blogu nebo v kategoriích e-shopu „Načíst další“ nebo nekonečné posouvání? Ověřte, že druhá stránka výpisu má vlastní adresu a vede na ni odkaz.
3. Nevydaný koncept článku byl veřejně dostupný a visel na 21 stránkách
Jak jsem to našla: porovnáním crawlu se sitemapou. Crawler našel článek, na který vedly odkazy, ale v sitemapě nebyl.
Co to znamenalo: článek bez data vydání byl dostupný komukoli a Google ho smí indexovat. Navíc se v boxu „Související články“ řadil jako nejnovější, protože prázdné datum se při řazení podle data dostalo na první místo. Visel tak nahoře na 21 článcích.
Jak se to opravilo: web teď nevydaný nebo naplánovaný článek nezobrazí a v souvisejících ho nenabídne. Konkrétní článek už měl zobrazení ve vyhledávání, proto dostal datum vydání a zůstal.
Co si z toho vzít: porovnejte, co je v sitemapě, s tím, co najde crawler. Rozdíl ukáže zapomenuté koncepty, testovací stránky i staré stránky, na které pořád vedou odkazy.
Co bylo v pořádku a co skoro
- PageSpeed Insights: mobil 93 až 95 bodů, počítač 100, žádné poskakování obsahu (CLS 0).
- Strukturovaná data: 0 chyb a 0 varování ve validátoru na 6 typech stránek.
- Varianty s www i bez a s http vedou jedním přesměrováním na jednu adresu. Robots.txt neblokuje nic, co Google potřebuje. Každá stránka má značku canonical sama na sebe.
- Skoro: načtení hlavního obsahu na mobilu (LCP) vycházelo v laboratorním měření na 2,9 až 3,2 s, tedy nad 2,5 s. Jako hlavní obsah Google měřil logo, nadpis úvodní stránky se kvůli animaci do měření nestihl započítat. Animaci jsem odstranila. Data od skutečných návštěvníků Google pro tak malý provoz nemá, takže PageSpeed Insights ukazuje jen laboratorní měření.
Core Web Vitals: co to je a jak je opravit
Core Web Vitals jsou tři měření toho, jak rychle a stabilně se stránka chová u skutečných návštěvníků. Google za dobré bere tyto hodnoty u 75 % návštěv:
| Měření | Co měří | Dobrá hodnota |
|---|---|---|
| LCP (Largest Contentful Paint) | za jak dlouho se zobrazí hlavní obsah | do 2,5 s |
| INP (Interaction to Next Paint) | jak rychle stránka zareaguje na klepnutí nebo kliknutí | do 200 ms |
| CLS (Cumulative Layout Shift) | jestli obsah při načítání neposkakuje | do 0,1 |
INP nahradil 12. března 2024 dřívější měření FID. Návod, který ještě radí řešit FID, je zastaralý.
Kde je uvidíte: v PageSpeed Insights po zadání adresy. Nahoře jsou data skutečných návštěvníků z Chromu, pokud jich má váš web dost. Dole je laboratorní měření jednoho načtení. Malé weby data návštěvníků často nemají, pak se řiďte laboratorním měřením. Za celý web je ukazuje Search Console v Přehledu Core Web Vitals, ale jen když má Google dost dat od návštěvníků. Laboratorní měření v PageSpeed Insights INP neměří, místo něj ukazuje Total Blocking Time.
Jak je opravit, podle toho, co neprochází:
- LCP: nejčastěji brzdí velká úvodní fotka nebo těžká úvodní stránka. U klientského webu půjčovny strojů jsem úvodní stránku zmenšila z 2,4 MB pod 1 MB a 141 obrázků převedla do lehčího formátu. Google u skutečných návštěvníků měří zobrazení hlavního obsahu kolem 1,8 s. Postupy jsou v článcích o zrychlení LCP, optimalizaci obrázků a formátech WebP a AVIF.
- INP: stránku zdržují skripty, typicky chatovací okna, měřicí kódy a doplňky, které na web přidávají reklamní systémy. Každý, který nepotřebujete, odeberte. Zbytek nechte načítat až po zobrazení obsahu.
- CLS: obsah poskakuje, když obrázky nemají zadané rozměry nebo když se nahoru dodatečně vloží lišta s cookies či banner. Podrobně v článku proč vám web skáče pod rukama.
Google píše, že dobré Core Web Vitals odpovídají tomu, co jeho hlavní systémy hodnocení odměňují. Samy o sobě vás ale před konkurenci s lepším obsahem nedostanou. Celý přehled je v článku Core Web Vitals, práci s nástrojem popisuje návod na PageSpeed Insights.
Technické SEO na WordPressu, Wixu, Shoptetu a Webnode
Co můžete ovlivnit, záleží na platformě. Na WordPressu skoro všechno, na hotových systémech jen to, co nabízí jejich nastavení.
| Platforma | Co nastavíte sami | Na co si dát pozor |
|---|---|---|
| WordPress | všechno: titulky, popisky, sitemapu a noindex obvykle v SEO pluginu, přesměrování pluginem nebo na hostingu, rychlost výběrem hostingu, šablony a pluginů | po dokončení webu zůstane zapnuté nastavení, které schová celý web před vyhledávači; každý další plugin může web zpomalit. Správa WordPressu |
| Wix | titulky a popisky v SEO panelu, úpravy robots.txt v Robots.txt Editoru, přesměrování 301 ve správci přesměrování, canonical | při změně adresy stránky vytvoří Wix přesměrování sám, u článků blogu ne. Přesměrování a propojení se Search Console fungují jen s placeným tarifem a vlastní doménou. Správa Wixu |
| Shoptet | titulky a popisky u produktů a kategorií, ruční přesměrování 301 v Marketing → Základní SEO → Přesměrování adres (URL), vlastní pravidla robots.txt | sitemapu generuje Shoptet a upravit ji nejde; vlastní pravidla robots.txt se jen připojí na konec. Automatické přesměrování po přejmenování produktu je jen v placené funkci Pokročilé SEO. Změna struktury adres v nastavení smaže všechna dosavadní přesměrování. Správa Shoptetu |
| Webnode | titulek, popisek a adresu stránky v SEO nastavení, přesměrování 301 přes alternativní URL, skrytí stránky pro vyhledávače; HTTPS a sitemapu řeší Webnode sám | propojení se Search Console vyžaduje prémiový balíček Standard, Profi nebo Business. Správa Webnode |
Rychlost Shoptet e-shopu ovlivníte hlavně tím, co do šablony přidáte: velikostí fotek, počtem doplňků a vložených kódů (měření, chaty, widgety). Samotný server a jádro šablony jsou na Shoptetu.
Technický audit, nebo obsahový audit?
Technický audit odpovídá na otázku, jestli Google stránky najde, načte a zařadí. Obsahový audit na otázku, jestli stojí za to je ukázat: odpovídají na to, co lidé hledají, nejsou zastaralé, neopakují se.
Začněte technikou, když v Search Console vidíte stránky vyřazené kvůli noindexu, robots.txt, chybě serveru nebo chybějící stránce (404). Tam je oprava rychlá a výsledek jistý. Když jsou stránky technicky v pořádku a Google je přesto neindexuje nebo neukazuje, je problém v obsahu.
Jak často technický stav kontrolovat
- Jednou měsíčně se podívejte do Search Console na přehled Stránky, Přehled Core Web Vitals a na přehledy Ručně provedené zásahy a Bezpečnostní problémy (ty ukážou postih od Googlu nebo napadený web). Při novém problému s indexací Search Console obvykle pošle i e-mail.
- Po každé změně webu: nová šablona, aktualizace pluginů, změna adres, přechod na jiný hosting. Patří sem i automatické aktualizace.
- Před redesignem nebo přechodem na jinou platformu: sepište si všechny dnešní adresy, abyste je mohli přesměrovat na nové.
- Celý web crawlerem projeďte aspoň jednou za rok. Najde, co Search Console neukáže: stránky bez odkazu, dvojí titulky, odkazy na přesměrované adresy.
Kdy technické SEO nechat na někom jiném
Sami zvládnete kontroly ze seznamu výš. Pomoc dává smysl, když:
- Search Console hlásí chyby a nevíte, které z nich vadí,
- po redesignu nebo změně platformy klesla návštěvnost z Googlu,
- důležité stránky nejsou v indexu a nevíte proč,
- technicky je prý všechno v pořádku, a ve vyhledávání vás přesto nevidět.
V tu chvíli potřebujete technický audit, který chyby nejen najde, ale i seřadí podle dopadu. To je Diagnóza webu: technika, obsah, konkurence a viditelnost v AI asistentech, písemně do 5 pracovních dnů od zaplacení a zpřístupnění Search Console, za 4 900 Kč. Search Console stačí zpřístupnit ke čtení, a když ji nemáte, pomůžu ji založit.
Pokud potřebujete hlavně, aby web technicky běžel, je tu správa webu od 790 Kč měsíčně. V balíčku Plus za 1 490 Kč jednou měsíčně projdu Search Console a nalezené technické chyby opravím v rámci hodiny úprav. Základy jedné stránky si můžete hned ověřit v online SEO kontrole.
Časté otázky
Zvládnu technické SEO bez programátora?
Kontroly ze seznamu ano, všechny jsou v Search Console, PageSpeed Insights a v prohlížeči. Opravy záleží na platformě. Na Wixu, Shoptetu a Webnode nastavíte titulky a přesměrování v administraci, na Wixu a Webnode i skrytí stránky před vyhledávači. Na WordPressu většinu přes SEO plugin. Programátora potřebujete u rychlosti, která závisí na šabloně, u chyb serveru a u přesunu webu na jiné adresy.
Proč Search Console hlásí chyby, když web funguje?
Protože část hlášení chybami není. Stav „Nenalezeno (404)“ u stránky, kterou jste smazali a nemá náhradu, je v pořádku. „Stránka s přesměrováním“ u staré adresy taky. Noindex u košíku nebo děkovací stránky po odeslání formuláře je taky správně. Řešte jen hlášení u stránek, které mají být ve vyhledávání.
Jak dlouho trvá, než se oprava projeví v Googlu?
Technická oprava se projeví, až Google stránku znovu projde. U důležité stránky to urychlíte tlačítkem Požádat o indexování v Kontrole adresy URL. Vyřazení stránek kvůli kvalitě se mění pomaleji: Google musí znovu vyhodnotit celý web, a to podle jeho dokumentace může trvat i několik měsíců.
Potřebuje web kvůli AI asistentům něco technicky navíc?
Pro AI přehledy a Režim AI v Googlu ne. Google píše, že stránka musí být v indexu a smět se zobrazit s úryvkem textu, a že žádné zvláštní soubory ani strukturovaná data navíc nejsou potřeba. U ChatGPT zkontrolujte robots.txt: když blokuje robota OAI-SearchBot, ChatGPT vaše stránky ve svých odpovědích s vyhledáváním neuvede jako zdroj.
Podrobně k jednotlivým tématům
- Indexace a procházení: sitemapa, robots.txt, noindex, IndexNow, analýza logů serveru, Google Discover
- Adresy a duplicity: 301 přesměrování, canonical, parametry v URL, subdoména, nebo složka, hreflang pro víc jazyků, web pro zahraničí
- Rychlost a mobil: Core Web Vitals, LCP, CLS, PageSpeed Insights, obrázky, WebP, AVIF a lazy loading, alt texty, mobilní verze, HTTPS
- Strukturovaná data: pro e-shopy, Product, LocalBusiness, FAQ, rozšířené výsledky, schema a AI
- JavaScript a stavba webu: JavaScript SEO, vykreslování SSR, CSR a SSG, Next.js, interní prolinkování
- Nástroje: Screaming Frog pokročile, Screaming Frog, nebo Sitebulb
