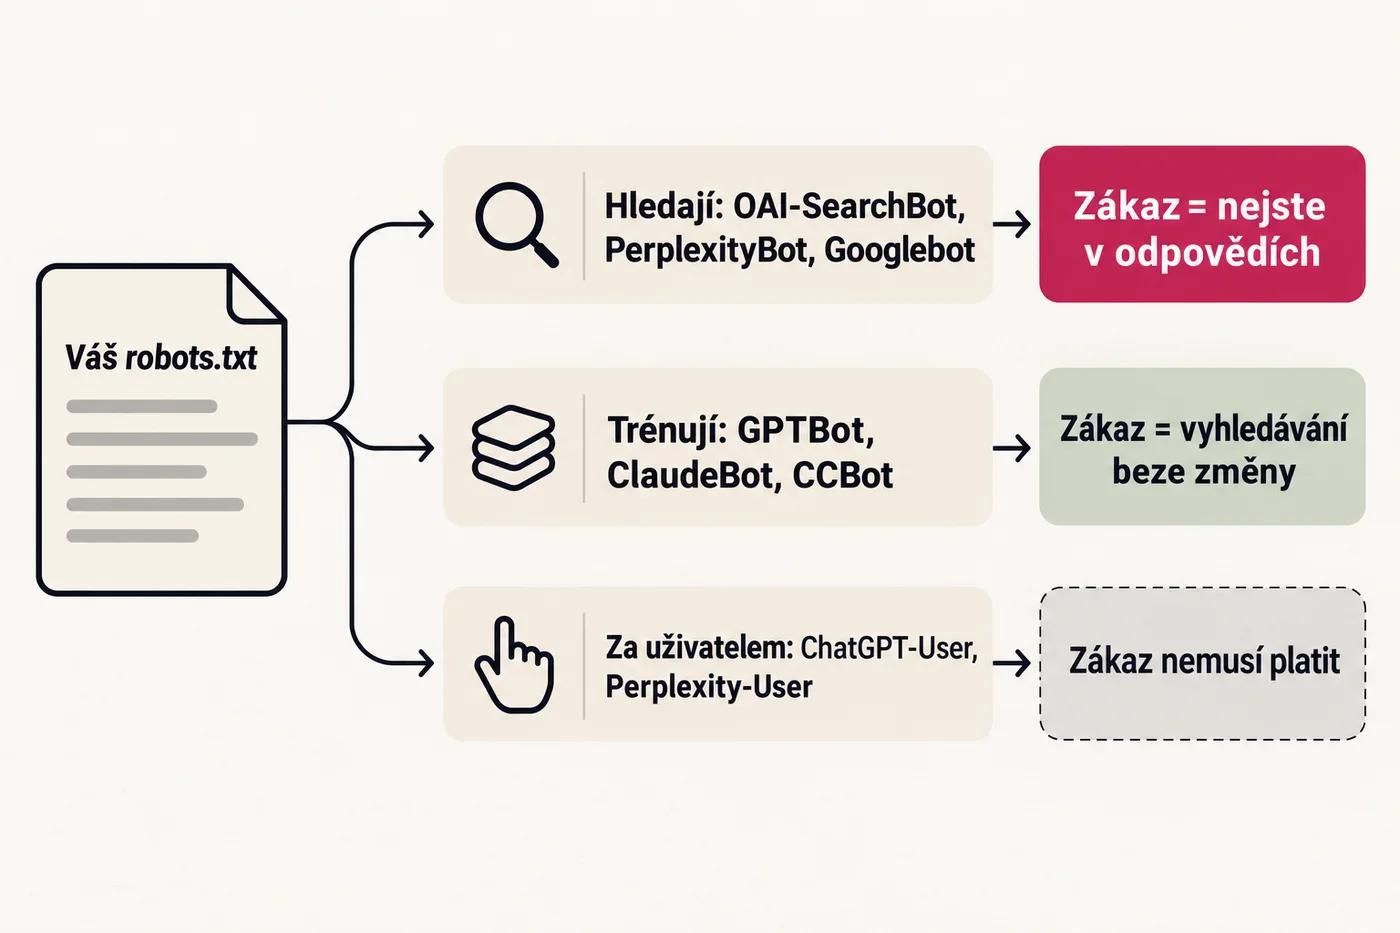
Roboty, kteří hledají pro ChatGPT, Perplexity, Claude, Google a Copilot (OAI-SearchBot, PerplexityBot, Claude-SearchBot, Googlebot, Bingbot), pusťte vždy: kdo je zablokuje, přichází o citace v jejich odpovědích. Zvažovat má smysl jen roboty a značky pro trénink modelů (GPTBot, ClaudeBot, Google-Extended, Applebot-Extended, CCBot). Jejich zákaz na vyhledávání v ChatGPT ani na AI přehledy Googlu (AI Overviews) vliv nemá.
Proč to rozlišení potřebujete znát: v rozboru pro tento web dostal 22. 10. 2026 Gemini s vyhledáváním Googlu čtyřikrát otázku „Mám blokovat GPTBot a další AI crawlery v robots.txt?“ a položil si k ní celkem 27 různých dílčích hledání. Devět se týkalo blokování (jak, koho a proč), jen jedno důvodů roboty pustit a žádné nezmínilo OAI-SearchBot ani PerplexityBot. Rada poskládaná z takové rešerše pak může snadno zablokovat i roboty, na kterých vaše viditelnost v AI stojí.
Tři druhy AI robotů: hledají, trénují, nebo přišli za uživatelem
Velké AI firmy posílají na web víc robotů s různým úkolem a v robots.txt řídíte každého zvlášť. OpenAI a Perplexity výslovně píšou, že nastavení jsou na sobě nezávislá.
- Vyhledávací roboti procházejí web, aby AI měla co citovat. Když je zakážete, nejste v odpovědích.
- Roboti pro trénink sbírají texty, na kterých se učí příští modely. Zákaz znamená hlavně „na mém obsahu netrénujte“, u Google-Extended navíc i to, že aplikace Gemini váš obsah nepoužije k ukotvení odpovědí.
- Roboti na pokyn uživatele přijdou, když člověk v chatu požádá o konkrétní stránku nebo když agent něco zařizuje. Část z nich robots.txt podle samotných provozovatelů respektovat nemusí.
Co který robot dělá a co znamená jeho zákaz
| Robot | Firma | K čemu slouží | Co udělá zákaz v robots.txt |
|---|---|---|---|
| OAI-SearchBot | OpenAI | vyhledávání v ChatGPT | web se v odpovědích vyhledávání ChatGPT neukáže, nanejvýš jako navigační odkaz |
| GPTBot | OpenAI | trénink modelů | obsah se nemá použít k tréninku, vyhledávání v ChatGPT beze změny |
| ChatGPT-User | OpenAI | stránka otevřená na pokyn uživatele | podle OpenAI se pravidla robots.txt uplatnit nemusí |
| Claude-SearchBot | Anthropic | vyhledávání v Claude | může snížit viditelnost ve výsledcích Claude |
| ClaudeBot | Anthropic | trénink modelů | budoucí obsah se vyřadí z tréninku |
| Claude-User | Anthropic | stránka otevřená na pokyn uživatele | Claude stránku pro uživatele nenačte |
| PerplexityBot | Perplexity | vyhledávání v Perplexity, ne trénink | nejste ve výsledcích Perplexity |
| Perplexity-User | Perplexity | stránka otevřená na pokyn uživatele | robots.txt podle Perplexity obecně ignoruje |
| Googlebot | vyhledávání včetně AI přehledů a Režimu AI (AI Mode) | Google web neprochází, přicházíte o vyhledávání i AI přehledy | |
| Google-Extended | trénink Gemini a ukotvení odpovědí v aplikaci Gemini | na Google vyhledávání ani AI přehledy vliv nemá | |
| Google-Agent | agent, který na web jde za uživatelem | patří mezi roboty, kteří robots.txt obecně ignorují | |
| Applebot | Apple | vyhledávání v Siri, Spotlightu a Safari | nejste v těchto výsledcích |
| Applebot-Extended | Apple | trénink modelů Apple | jen zákaz tréninku, sám nic neprochází |
| Bingbot | Microsoft | vyhledávání Bing | nejste ve výsledcích Bingu, a tím ani v Copilotu, který z indexu Bingu čerpá |
| SeznamBot | Seznam.cz | vyhledávání Seznamu | Seznam web pro své vyhledávání neprochází |
| Seznam-Extended | Seznam.cz | AI odpovědi Seznamu | Seznam váš web nepoužije jako zdroj AI odpovědí |
| CCBot | Common Crawl | otevřený archiv webu, z něhož se trénují i modely | do archivu se nedostanete |
Zdroje: OpenAI, Anthropic, Perplexity, Google, běžní roboti a roboti na pokyn uživatele, Apple, Microsoft, Seznam, Common Crawl; ověřeno 23. 10. 2026.
Dvě věci z tabulky stojí za zdůraznění. Seznam zákaz AI odpovědí přijímá pod třemi jmény (Seznam-Extended, AI a MachineLearning) a stačí kterékoli z nich, takže skupina User-agent: AI s Disallow: /, kterou někdo kdysi přidal „pro jistotu“, vás vyřadí ze Seznam AI (dříve Seznam Asistent). A Apple může odpovědi Siri na obecné otázky doplňovat obsahem, který prochází běžný Applebot. Z těchto odpovědí se web vyřadí značkou nosnippet, zákaz Applebot-Extended se na ně nevztahuje.
Blokovat, nebo pustit? Podle toho, co chcete
Pro firmu, která chce poptávky, je odpověď skoro vždy „pustit“. Robots.txt je přitom jen podmínka: koho AI z puštěných webů nakonec cituje, rozebírá průvodce GEO optimalizací. Rozhodnutí podle cíle:
| Co chcete | Co nastavit | Co tím ztratíte |
|---|---|---|
| Aby vás AI našla a citovala (většina firem a e-shopů) | pustit všechny vyhledávací roboty, trénink podle vás | nic; když zakážete Google-Extended, ukotvení odpovědí v aplikaci Gemini |
| Být v AI odpovědích, ale nechci, aby se na mém obsahu trénovalo | zakázat GPTBot, ClaudeBot, Google-Extended, Applebot-Extended a CCBot | aplikace Gemini nebude odpovědi ukotvovat vaším obsahem |
| Zmizet z AI přehledů Googlu, ale zůstat ve výsledcích | ne v robots.txt: Search Console, Nastavení, Generativní AI ve Vyhledávání | zobrazení a návštěvy z AI přehledů, Režimu AI a AI funkcí v Objevit (Discover) |
| Nebýt v AI odpovědích vůbec (třeba placený obsah) | zakázat i vyhledávací AI roboty a Seznam-Extended, vyřadit web v Search Console, roboty na pokyn uživatele řešit firewallem | citace a návštěvy ze všech AI |
Pozor na dvě nedorozumění. Z AI přehledů vás nedostane zákaz Google-Extended, ale až vyřazení v Search Console (pro všechny weby od 31. 8. 2026, nápověda), nebo značka nosnippet, která ale vypne i úryvek v běžných výsledcích. A zákaz robota pro trénink není mazání: Anthropic píše, že zákaz ClaudeBot vyřadí z tréninku budoucí obsah webu.
Co se stane, když vás AI přehledy přestanou zobrazovat, rozebírá článek AI přehledy v Googlu, jak se dostat do odpovědí ChatGPT, článek ChatGPT a Claude jako vyhledávače.
Ukázka robots.txt: vidět v AI hledání, bez tréninku
Tahle varianta pouští všechny vyhledávače i vyhledávací AI roboty a zakazuje jen sběr pro trénink:
# Všichni ostatní roboti, včetně vyhledávacích AI: pravidla skupiny *
User-agent: *
Disallow: /admin/

# Trénink modelů: zakázat
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: CCBot
Disallow: /

Sitemap: https://www.vasweb.cz/sitemap.xml
Místo Disallow: /admin/ nechte pravidla, která v souboru máte dnes. Kdo chce pustit i trénink, druhou skupinu vynechá.
Nenápadná chyba vzniká, když někdo „pro jistotu“ přidá pro AI robota zvláštní skupinu s Allow: /. Mezi 27 obchody z referencí Shoptetu ji 23. 10. 2026 měl jeden, se skupinami pro GPTBot a ChatGPT-User. Robot, který najde skupinu se svým jménem, se podle Googlu i podle standardu RFC 9309 řídí jen jí a skupinu * ignoruje. Přestanou pro něj platit zákazy, které máte pro ostatní, třeba košík nebo filtry v e-shopu. Robots.txt jako celek popisuje článek robots.txt: strážce brány.
Jak je nastavený robots.txt tohoto webu
Robots.txt webu seopohotovost.cz (verze z 6. 10. 2026) pouští všechny vyhledávače, všechny vyhledávací AI roboty i vyjmenované roboty pro trénink. Komentář v souboru uvádí, že trénink je povolený záměrně, aby modely značku a obsah znaly. Jména robotů (od Googlebota a SeznamBota po OAI-SearchBot, Claude-SearchBot, GPTBot, Google-Extended a CCBot) jsou vypsaná ve stejné skupině jako *, takže všichni dostanou stejná pravidla: neprocházet interní aplikaci, API a technické adresy Next.js. Zákaz v robots.txt mají jen Bytespider a img2dataset. Bytespidera navíc zastaví firewall (23. 10. 2026 dostal na úvodní stránce odpověď 403, GPTBot 200).
Vypsaná jména jsou jen čitelná deklarace, stejně by fungovala samotná hvězdička. Proto nevadí, že chybí třeba Seznam-Extended.
Jak si robots.txt zkontrolujete sami
Jestli nějakého důležitého robota neblokujete, zjistíte takhle:
- Otevřete v prohlížeči adresu
vasweb.cz/robots.txt. Když soubor neexistuje (chyba 404), Google to bere tak, že žádná omezení nejsou. - Najděte řádky
Disallow: /(lomítko bez ničeho za ním = celý web). PodUser-agent: *blokují všechny včetně Googlu. Pod jménem z tabulky výš blokují toho robota; zkontrolujte hlavně OAI-SearchBot, PerplexityBot, Claude-SearchBot, Bingbot, SeznamBot, Seznam-Extended aAI. - Projděte skupiny s jménem AI robota a
Allow: /. Pro tyto roboty neplatí vaše ostatní pravidla. - V Search Console otevřete v Nastavení Přehled souborů robots.txt. Ukáže, jestli Google soubor načetl a zda v něm nenašel chyby.
- Zkontrolujte firewall nebo CDN. Cloudflare umí AI roboty blokovat bez jediného řádku v robots.txt. Pro nové domény oznámil, že od 15. 9. 2026 bude na stránkách s reklamou ve výchozím stavu blokovat roboty pro trénink (včetně těch, kteří slouží zároveň vyhledávání) a roboty jednající za uživatele.
- Po opravě počkejte. OpenAI uvádí, že se změna ve vyhledávání ChatGPT projeví zhruba do 24 hodin, Perplexity nejvýš do 24 hodin.
Kde robots.txt upravíte na Shoptetu a WordPressu
Shoptet: v administraci Vzhled a Obsah, Editor, HTML kód, sekce Robots.txt. Podle nápovědy Shoptetu se vložený text přidá na konec souboru, který Shoptet generuje sám, a vejde se do něj nejvýš 8 192 znaků. Skupina s Disallow: / pro roboty na trénink tak funguje bez úprav. Zvláštní skupinu s Allow: / pro AI vyhledávače ale nevkládejte: roboti v ní by přestali respektovat pravidla Shoptetu pro košík, přihlášení a filtry. Pole llms.txt hned vedle je jiný soubor: popisuje obsah, nic nepovoluje ani nezakazuje, a vyhledávání Google ho podle svého průvodce ignoruje.
Na Shoptetu si všimněte ještě jednoho řádku. Z 27 e-shopů na Shoptetu, na které 23. 10. 2026 odkazovala stránka referencí, mělo 20 ve skupině * řádek Content-Signal, nejčastěji search=yes, ai-train=no; dva obchody trénink naopak povolují (ai-train=yes). Shoptet ho do souboru vkládá sám, hned pod User-agent: *, kam se text z HTML kódů nedostane, a u některých obchodů s jinými hodnotami. Kde se nastavuje, nápověda Shoptetu neuvádí. Je to signál ze zásad Content Signals Policy, které v září 2025 představil Cloudflare; nejčastější varianta search=yes, ai-train=no znamená „vyhledávání ano, trénink AI ne“. Žádného robota neblokuje, je to vyjádření přání, které podle Cloudflaru některé firmy můžou ignorovat. Tato varianta se k AI odpovědím (signál ai-input) nevyjadřuje, některé obchody ho ale uvádějí (ai-input=yes). Dokumentace robotů OpenAI, Anthropicu, Googlu ani Perplexity ho nezmiňuje.
WordPress: když v kořeni webu není skutečný soubor robots.txt, WordPress ho generuje sám (zakazuje jen /wp-admin/). S pluginem Yoast SEO ho upravíte v Yoast SEO, Tools (Nástroje), File Editor (Editor souborů). Když položka chybí, má web úpravy souborů vypnuté a soubor robots.txt se nahraje do kořene webu přes FTP.
Časté otázky
Co je GPTBot?
GPTBot je robot OpenAI, který sbírá obsah webů pro trénink jejích modelů. Jeho zákaz vyhledávání v ChatGPT neovlivní, to obstarává OAI-SearchBot.
Co je CCBot?
CCBot je robot neziskové nadace Common Crawl, která buduje otevřený archiv webu dostupný komukoli. Z jejích dat se trénují i jazykové modely, například GPT-3 od OpenAI měl filtrovaný Common Crawl jako největší část tréninkových dat (studie OpenAI z roku 2020). Common Crawl upozorňuje, že se za CCBot vydávají i cizí roboti, a doporučuje ověřovat jejich IP adresy.
Jaký je rozdíl mezi Googlebotem a Google-Extended?
Googlebot prochází web pro vyhledávání Google, a tím i pro AI přehledy a Režim AI: přístup AI funkcí vyhledávání podle Googlu řídí pravidla robots.txt pro Googlebota. Google-Extended žádné stránky neprochází, je to jen značka v robots.txt, kterou říkáte, jestli Google smí obsah, který stáhli jeho roboti, použít k tréninku Gemini a k ukotvení odpovědí v aplikaci Gemini.
Jak zablokovat konkrétního AI robota?
Skupinou s jeho jménem a řádkem Disallow: /, jako v ukázce výš. Robots.txt je ale pokyn, ne zámek. Roboti na pokyn uživatele (ChatGPT-User, Perplexity-User, Google-Agent) ho podle svých provozovatelů respektovat nemusí. Spolehlivě je zastaví až firewall nebo CDN, Anthropic ale upozorňuje, že blokování IP adres může zabránit jeho robotům přečíst si váš robots.txt.
