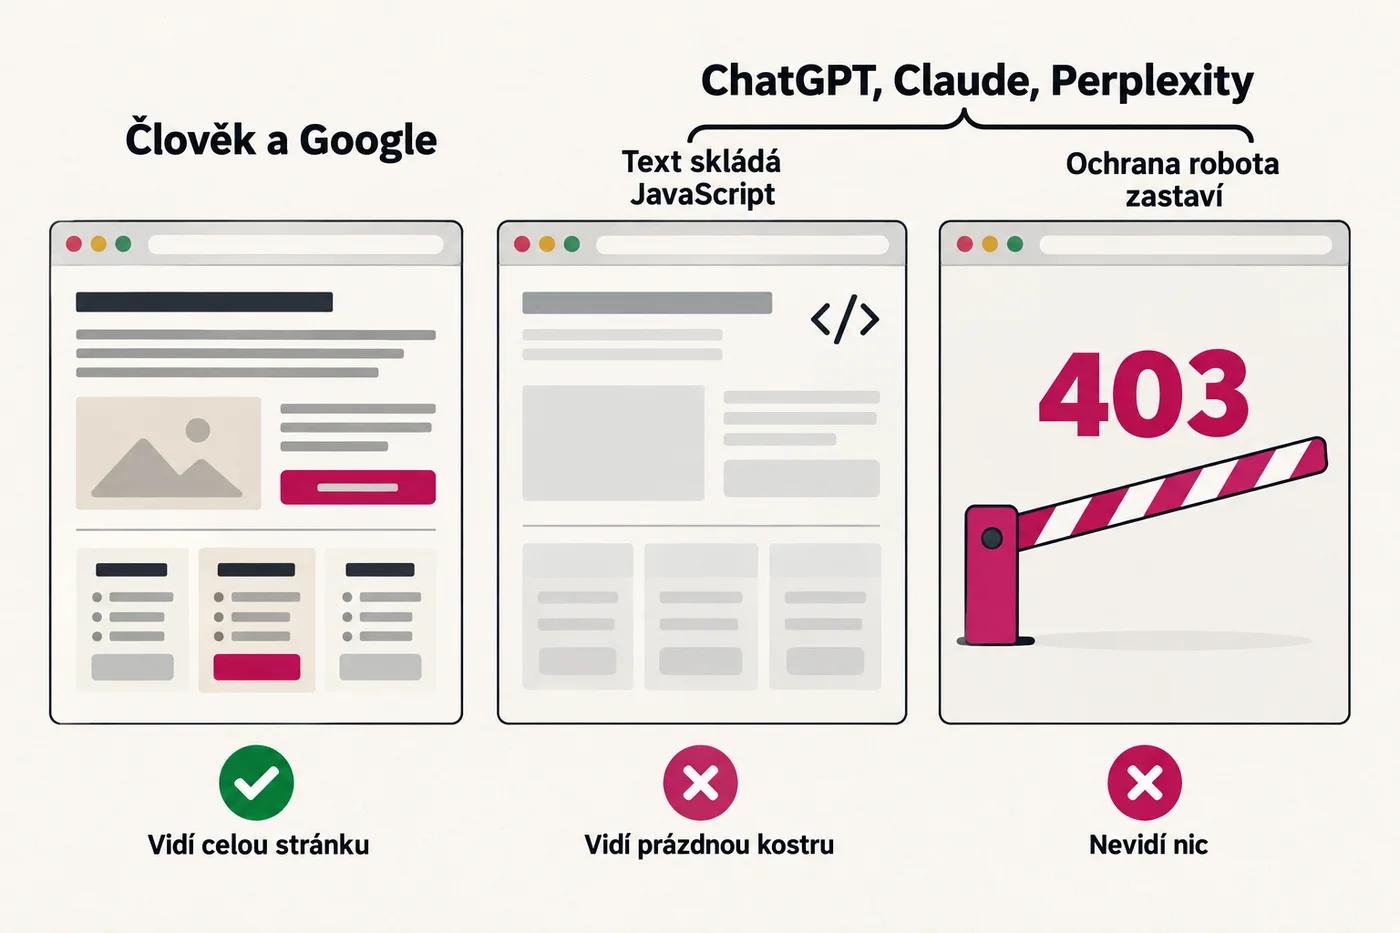
Když vás ChatGPT, Claude nebo Perplexity nezmíní, přestože na otázku zákazníka máte na webu nejlepší odpověď, příčina nemusí být v textu. Robot AI může místo stránky dostat prázdný kód, chybu nebo zákaz, a nikdo vás na to neupozorní: lidem web funguje, Google ho většinou má v indexu, jen vyhledávání AI ho nevidí.
Obvyklých příčin je sedm. Kterou má váš web, většinou zjistíte postupem níž.
Sedm tichých blokací v přehledu
| Příčina | Co robot AI dostane | Koho se týká | Jak to poznáte |
|---|---|---|---|
| Text se skládá až JavaScriptem | stránku bez textu | roboty ChatGPT, Claude, Perplexity (podle měření z roku 2024, jejich dokumentace o tom mlčí); Google ne | zdrojový kód stránky |
| Nastavení AI robotů v Cloudflaru | chybu 403, 402 nebo výzvu | podle nastavení trénink, agenty, při volbě Block i Google | Cloudflare, AI Crawl Control |
| Ochrana hostingu nebo firewall (WAF) | chybu 403, 429 nebo vlastní kód ochrany | roboty, které ochrana nepustí | logy serveru |
| Zákaz v robots.txt | nic, slušný robot nepřijde | vyjmenované roboty | soubor robots.txt |
| Obsah za přihlášením | přihlašovací formulář | všechny roboty | anonymní okno prohlížeče |
| Značka noindex | stránku, kterou vyhledávač nezařadí | AI přehledy a Režim AI v Googlu | zdrojový kód, Search Console |
| Pomalý nebo přetížený server | chybu 5xx nebo nic | všechny; Google pak prochází méně | logy, Search Console |
Společné mají jedno: na webu nic nevypadá rozbitě. Proto se na ně přichází pozdě.
JavaScript: co vidí robot, který stránku jen stáhne
Roboti ChatGPT, Claude a Perplexity podle dostupných měření JavaScript nespouštějí, takže znají jen text, který server pošle rovnou v HTML. Google je výjimka: jeho dokumentace k JavaScriptu popisuje, že stránky vykresluje v prohlížeči Chromium, a sama připomíná, že ne všichni roboti JavaScript spustit umí.
OpenAI, Anthropic ani Perplexity ve své dokumentaci k robotům (k 26. 10. 2026) neuvádějí, zda JavaScript spouštějí. Nejznámější veřejné měření zveřejnil Vercel s firmou MERJ v prosinci 2024: žádný z velkých AI robotů, mezi nimi OAI-SearchBot, ChatGPT-User, GPTBot, ClaudeBot a PerplexityBot, JavaScript nevykresloval. Roboty Claude-SearchBot, Claude-User a Perplexity-User měření nezahrnuje. Roboti OpenAI a Anthropicu soubory JavaScriptu stahovali, ale nespouštěli. Gemini podle stejného měření využívá infrastrukturu Googlebota, takže vykreslený obsah vidí. Totéž platí pro AI přehledy (AI Overviews) a Režim AI (AI Mode), které stojí na indexu Googlu.
Týká se to hlavně dvou situací:
- Web postavený jako aplikace v Reactu, Vue nebo Angularu, který text skládá až v prohlížeči (vykreslování v prohlížeči, anglicky client-side rendering). Robot dostane titulek, popis a prázdnou kostru.
- Obsah, který se dočítá až po akci: recenze načítané z jiné služby, ceny v kalkulačce, tlačítko „Načíst další“, filtry v e-shopu. Zbytek stránky robot vidí, tohle ne.
Web, kterému hotové HTML posílá server (klasický WordPress, weby se serverovým vykreslováním), tenhle problém nemá. Jak web předělat, aby text byl v HTML hned, rozebírá článek JavaScript SEO. Funkce Markdown for Agents od Cloudflaru (placené tarify Pro, Business a Enterprise) to nevyřeší: podle dokumentace převádí na markdown HTML, které dostane ze serveru, takže text, který v HTML chybí, nepřibude.
Cloudflare: co blokuje a co se změnilo 15. 9. 2026
Cloudflare blokuje AI roboty jen podle nastavení vaší domény. To nastavení ale mohlo vzniknout samo při zakládání domény, nebo jedním přepínačem s dopadem, který nikdo nečekal.
- Od 1. 7. 2025 se Cloudflare každé nové domény při přidání do Cloudflaru ptá, jestli AI roboty pustit, a výchozím stavem je kontrola, ne volný přístup (tisková zpráva Cloudflare).
- Od 1. 7. 2026 se AI provoz řídí ve třech skupinách, i na bezplatném tarifu: vyhledávání (Search), agenti, kteří jednají za člověka (Agent), a trénink modelů (Training) (Cloudflare).
- Od 15. 9. 2026 nabízí Cloudflare novým doménám jedno ze dvou doporučených nastavení podle toho, jestli web vydělává na reklamě (blog Cloudflare):
| Skupina robotů | Web bez reklamy | Web s reklamou |
|---|---|---|
| Vyhledávání (Search) | povolit | povolit |
| Trénink (Training) | povolit | Disallow AI Training: zákaz tréninku v robots.txt, ostatní roboti pro trénink zablokovaní, Googlebot a Bingbot dál procházejí pro vyhledávání |
| Agenti (Agent) | povolit | blokovat na stránkách s reklamou |
Dvě volby mají dopad, který z názvu nepoznáte:
- Block u tréninku zastaví i Google. Od 15. 9. 2026 platí volby Block a „Block on pages with ads“ i pro roboty, kteří slouží vyhledávání i tréninku zároveň, a Cloudflare mezi ně výslovně řadí Googlebot, Bingbot a Applebot. Kdo zvolí Block, zavře web i Googlebotu a Bingbotu, tedy i vyhledávání Googlu, Bingu a Copilotu, který podle Microsoftu stojí na indexu Bingu. Volba „Block on pages with ads“ udělá totéž na stránkách s reklamou. Kdo chce zakázat jen trénink, volí Disallow AI Training. Bingu ale Cloudflare zákaz tréninku touto volbou zatím nepředá, Microsoft podporu chystá na začátek roku 2027.
- Blokování agentů zavře dveře chatu. Agenti jsou podle Cloudflaru i roboti, kteří stránku otevírají na pokyn uživatele, třeba ChatGPT-User. Když je blokování agentů zapnuté a zákazník ChatGPT požádá, ať se podívá na váš ceník, ChatGPT stránku nedostane.
U stávajících domén Cloudflare podle svého blogu převedl staré nastavení na nové samo; kdo měl zapnuté staré „Block AI bots“, má teď u tréninku Disallow AI Training a agenty, třeba ChatGPT-User, zablokované na stránkách s reklamou. Když chcete, aby ChatGPT na pokyn zákazníka otevřel i takovou stránku, změňte u agentů (Agent) volbu na Allow. Přesto se vyplatí podívat do Security Settings, na nastavení AI robotů, a do přehledu AI Crawl Control, který je podle Cloudflaru dostupný na všech tarifech a ukazuje, kteří roboti AI přišli a co dostali. Pro představu: vyhledávací roboty podle Cloudflaru blokuje méně než 1 % webů v jeho síti, nějaký zákaz tréninku má zapnutý 17 %.
Ochrana hostingu a firewall: zákaz, o kterém nevíte
Firewall webových aplikací (WAF) nebo ochrana proti botům u hostingu může roboty AI odmítat bez ohledu na robots.txt, a to i ty vyhledávací. Proto OpenAI u OAI-SearchBot a Perplexity u PerplexityBot doporučují kromě robots.txt povolit i požadavky z jejich zveřejněných IP adres. Perplexity k tomu výslovně píše, že s firewallem může být potřeba jeho roboty povolit ručně, a přikládá návod pro Cloudflare a AWS. Anthropic naopak upozorňuje, že blokování jeho IP adres může robotům znemožnit přečíst si robots.txt.
Poznáte to podle odpovědí v logu: 403 (zakázáno), 429 (příliš mnoho požadavků), 503 nebo vlastní kód ochrany, případně výzva „ověřte, že jste člověk“, kterou robot nevyřeší.
Co ukázal test 251 českých webů
Pro tento článek jsem 26. 10. 2026 prošla 260 českých webů, které Google ukazuje na dotazy o SEO, AI a webech (výsledky vyhledávání ze Semrushe, 22. 10. 2026). Každou úvodní stránku jsem stáhla pětkrát: jednou jako prohlížeč a čtyřikrát s hlavičkou robota GPTBot, OAI-SearchBot, ClaudeBot a PerplexityBot. Prohlížeči odpovědělo bez chyby 251 webů.
- 60 webů odmítlo aspoň jednu hlavičku AI robota (kódy 403, 429, 402 nebo vlastní kód ochrany). 27 z těchto 60 odmítnutí nejspíš nenastavil majitel webu, ale pravidla dvou hostingů.
- 39 webů odmítlo jen GPTBot nebo ClaudeBot, tedy roboty pro trénink, a OAI-SearchBot s PerplexityBotem pustilo. 13 z nich je podle všeho u jednoho hostingu, jehož ochrana odmítla hlavičku ClaudeBota kódem 429 (příliš mnoho požadavků) hned na první požadavek, zatímco PerplexityBota těsně po něm pustila. Claude-SearchBota, kterého Claude používá pro vyhledávání, test nezkoušel, takže o citacích v Claude neříká nic.
- 21 webů odmítlo i OAI-SearchBot nebo PerplexityBot. 14 z nich je za ochranou druhého hostingu. Ta odmítla vlastním kódem 455 hlavičky robotů OpenAI (GPTBot, OAI-SearchBot) a stejně i hlavičku Googlebota, přestože tyto weby Google prochází. ClaudeBota a PerplexityBota pustila. Pravděpodobný výklad: ochrana ověřuje IP adresy robotů, jejichž adresy zná, a podvrženou hlavičku odmítne. Co u těchto 14 webů dostane skutečný robot OpenAI, test z cizího počítače neukáže.
- Jeden web odpověděl hlavičkám OAI-SearchBot a ClaudeBot kódem 402 (Payment Required): za procházení chce zaplatit.
- Dva weby měly v HTML bez JavaScriptu méně než 50 slov. Jeden je webová aplikace, druhý web služeb postavený v JavaScriptu: robot z něj dostane titulek a popis, ale z textu stránky ani jednu větu.
Z testu plynou dvě věci. Blokace AI robotů je běžná a velkou část z nich nenastavil majitel webu, ale hosting, takže o ní majitel nemusí vědět. A test s hlavičkou robota je jen vodítko a může se mýlit oběma směry: ochrana, která ověřuje IP adresy, odmítne i test, který by skutečný robot prošel. Jistotu dá až log serveru.
Robots.txt, přihlášení, noindex a pomalý server
Robots.txt. Koho pustit a koho ne, rozebírá článek AI boti a robots.txt. Méně známá past: když soubor robots.txt vrací chybu serveru (5xx), Google podle své specifikace prvních 12 hodin neprochází celý web a dalších 30 dní používá poslední funkční verzi. Firewall, který chrání i robots.txt, tak může zbrzdit i Google.
Přihlášení. Co je za přihlášením, věkovou bránou nebo zdí, která bez souhlasu nic neukáže, robot neuvidí. Ceník jen pro registrované zákazníky AI nezná a odpověď na otázku „kolik to stojí“ vezme jinde.
Noindex. Pro AI přehledy a Režim AI musí být stránka podle Googlu zaindexovaná a smět se zobrazit s úryvkem. Značka noindex často zůstane z doby vývoje. WordPress ji podle své dokumentace vloží na celý web, když je v nastavení čtení zaškrtnutá volba, aby vyhledávače web neindexovaly (Discourage search engines from indexing this site).
Pomalý server. Když web zpomalí nebo vrací chyby 5xx, Google podle své dokumentace prochází méně. Jak dlouho na odpověď čekají roboti AI, OpenAI, Anthropic ani Perplexity nezveřejňují. Search Console to u Googlu ukáže v Nastavení, přehled Statistiky procházení.
Jak si to ověříte sami
Stačí k tomu prohlížeč, pro druhý krok terminál.
- Podívejte se do zdrojového kódu. V Chromu stiskněte Ctrl+U (na Macu Option+Cmd+U), pak Ctrl+F (Cmd+F) a hledejte větu z hlavního textu, cenu nebo název služby. Co ve zdrojovém kódu není, roboti ChatGPT, Claude a Perplexity podle všeho nevidí.
- Stáhněte stránku s hlavičkou robota. V terminálu:
Příkaz vypíše číslo odpovědi. 200 je v pořádku. Kód 403, 429, 503 nebo neznámé číslo znamená, že něco robota se stejnou hlavičkou zastaví. Ochrana, která ověřuje IP adresy, může odmítnout váš test a skutečného robota přitom pustit; u části webů v testu výš to tak nejspíš je. Výsledek berte jako otázku pro hosting, ne jako verdikt.
curl -s -o /dev/null -w "%{http_code}\n" -A "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.0.0 Safari/537.36; compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot" https://www.vasweb.cz/ - Projděte logy. V přístupovém logu (access log) u hostingu nebo v AI Crawl Control v Cloudflaru hledejte OAI-SearchBot, ChatGPT-User, Claude-SearchBot, Claude-User, PerplexityBot a Perplexity-User a podívejte se, jaký kód dostávali. Jen tady vidíte skutečné roboty. Když tam za poslední měsíc žádný není, je to stejně důležitá informace.
- Zeptejte se chatu. Napište do ChatGPT nebo Perplexity: „Otevři https://www.vasweb.cz/cenik a napiš první větu hlavního textu.“ Když odpoví, že stránku otevřít nemůže, nebo cituje něco, co tam není, je to signál, že se k obsahu nedostal.
- Porovnejte to s Googlem. V Google Search Console otevřete Kontrolu URL, pak Živý test a Zobrazit testovanou stránku. Google ukáže, co vidí po vykreslení. Když tam text je, ale ve zdrojovém kódu z bodu 1 chybí, Google vás vidí a ostatní AI ne.
Jestli je text vidět bez JavaScriptu a jestli robots.txt pouští roboty AI, patří i ke kontrolám v Diagnóze webu. Když je web vidět, další krok popisuje průvodce GEO optimalizací: co rozhoduje o tom, koho AI z dostupných webů cituje.
Časté otázky
Jak v Cloudflaru povolit GPTBot?
V Security Settings nastavte u tréninku (Training) volbu Allow; jen pro GPTBot to jde v AI Crawl Control, kde se pravidla nastavují pro jednotlivé roboty. GPTBot ale slouží tréninku modelů. Pro vyhledávání v ChatGPT je podstatný OAI-SearchBot a nastavení obou robotů jsou podle OpenAI na sobě nezávislá, takže zákaz tréninku volbou Disallow AI Training vaši viditelnost v ChatGPT neohrozí.
Proč ChatGPT napíše, že nemůže otevřít můj web?
Když ChatGPT na pokyn uživatele otevírá stránku, posílá robota ChatGPT-User. Pravidla robots.txt se na něj podle OpenAI uplatnit nemusí, takže příčinu hledejte spíš ve firewallu, v nastavení agentů v Cloudflaru, v přihlášení nebo v obsahu načítaném JavaScriptem.
Prochází ChatGPT web živě?
Ano, a prochází ho i předem. OAI-SearchBot prochází weby předem pro vyhledávání v ChatGPT a ChatGPT-User navštíví stránku ve chvíli, kdy se na ni uživatel ptá. Web, který zakáže OAI-SearchBot, se podle OpenAI v odpovědích vyhledávání ChatGPT neukáže, nanejvýš jako navigační odkaz.
