AI asistent cituje jen stránky, které si v okamžiku dotazu sám vyhledá: Google ve svém indexu, Copilot v Bingu, ChatGPT vlastním robotem a u partnerských vyhledávačů, Perplexity hlavně vlastním robotem. Kdo v tom vyhledávání chybí, citovaný nebude. Podrobná pravidla výběru ale nezveřejňuje žádný z provozovatelů a většina toho, co se o nich píše, jsou korelace z dat výrobců SEO nástrojů.
Odkud AI bere odpověď: z paměti, nebo z vyhledávání
Odpověď vzniká dvěma cestami a citace s odkazem jen u jedné z nich. Model buď odpoví z toho, co se naučil při tréninku, nebo si nejdřív vyhledá aktuální stránky a odpověď složí z nich. Té druhé cestě se říká ukotvení (grounding), odborně RAG (retrieval-augmented generation, generování s vyhledáním).
Kdy model hledá, rozhoduje sám. Podle nápovědy OpenAI ChatGPT hledá automaticky, když otázce pomůže aktuální informace. Podle dokumentace Gemini API model nejdřív posoudí, jestli mu vyhledávání Googlu odpověď zlepší, a teprve pak pošle jeden nebo víc dotazů. V našem testu z 22. 10. 2026 (popis metody je v článku o query fan-out) Gemini u 11 z 80 odpovědí nehledal vůbec.
Pro firmu z toho plyne jednoduché rozdělení:
- Co model ví z tréninku, ovlivníte jen pomalu a nepřímo: tím, co se o vás dlouhodobě píše na webu. Odkaz na váš web z toho nevznikne.
- Co model dohledá, ovlivníte svým webem hned, jakmile ho vyhledávač daného asistenta zná. Tady vznikají citace.
Z jakého vyhledávání který asistent bere stránky
Každý asistent hledá jinde, a proto vás jeden cituje a druhý vůbec nezná.
| Asistent | Kde hledá (podle provozovatele) | Co z toho plyne pro web |
|---|---|---|
| AI přehledy (AI Overviews) a Režim AI (AI Mode) | index Googlu, stránky vybírají hlavní systémy řazení Vyhledávání | stránka musí být v indexu a smět se zobrazit s úryvkem, nic dalšího Google nevyžaduje |
| Gemini (aplikace) | index Vyhledávání Google | blokace Google-Extended v robots.txt vás z ukotvení v aplikaci Gemini vyřadí, z Vyhledávání ne |
| ChatGPT | vlastní robot OAI-SearchBot a podle nápovědy občas partnerští poskytovatelé vyhledávání (odkazuje na zásady Microsoftu a Shopify) | web, který OAI-SearchBot zablokuje, se ve vyhledávání ChatGPT neukáže, nanejvýš jako navigační odkaz |
| Copilot | index Bingu | web, který Bing nezná, nemá Copilot odkud vzít |
| Perplexity | hlavně vlastní robot PerplexityBot, který slouží jen vyhledávání, ne tréninku; při dotazu uživatele může stránku navštívit i Perplexity-User | povolit PerplexityBot v robots.txt i ve firewallu |
Jednu věc OpenAI popisuje konkrétně: ChatGPT otázku uživatele před hledáním přepíše do jednoho nebo víc cílených dotazů a partnerskému vyhledávači pošle i přibližnou polohu podle IP adresy. Z „dobré restaurace poblíž“ tak udělá dotaz s názvem města. Pro místní firmu to znamená, že na webu musí být jasně napsané, kde působí. Které roboty pustit a které můžete zablokovat, rozebírá článek AI boti a robots.txt.
Co o výběru citací říkají samy firmy, které AI provozují
Oficiálně říkají málo a v jádru totéž: AI vybírá z výsledků vlastního vyhledávání a cituje stránky, které podporují konkrétní informaci v odpovědi.
- Google v průvodci optimalizací pro AI (aktualizace 10. 7. 2026) píše, že AI funkce si stránky vyhledávají pomocí hlavních systémů řazení, z nalezených stránek vyberou konkrétní informace a ukážou odkazy, které je podporují. Model k tomu může položit několik souvisejících dotazů najednou (query fan-out). Vyrábět kvůli tomu samostatný obsah na každý dílčí dotaz hlavně pro lepší řazení ale Google označuje za porušení pravidel proti spamu (zneužívání obsahu ve velkém). Speciální soubory jako llms.txt, zvláštní schéma ani dělení textu na drobné kousky Vyhledávání Google nepotřebuje, llms.txt podle Googlu přímo ignoruje.
- Microsoft v blogu Microsoft Advertising (8. 10. 2025) uvádí, že AI asistenti nečtou stránku odshora dolů, ale rozdělí ji na menší části a řadí právě ty. Tajná strategie, jak se nechat vybrat, podle něj neexistuje, úspěch ale začíná u obsahu, který je aktuální, důvěryhodný, dobře členěný a jednoznačný.
- OpenAI v nápovědě ani v dokumentaci k robotům kritéria výběru zdrojů nepopisuje. Uživatelům naopak radí otevřít citovaný zdroj, ověřit, že odpověď opravdu podporuje, a podívat se, kdy byl zveřejněný nebo aktualizovaný.
- Perplexity v nápovědě píše, že hledá na internetu v reálném čase, sbírá informace z „autoritativních zdrojů, jako jsou články, weby a odborné časopisy“, a každou odpověď opatří číslovanými citacemi. Co pro něj znamená autoritativní, neupřesňuje.
Doložené je tedy tohle: musíte být ve vyhledávání daného asistenta, u Googlu i na dílčí dotazy. Podle Microsoftu navíc pomáhá, když konkrétní informace stojí v samostatné pasáži; Google to nevyžaduje. Všechno ostatní je odhad.
Co ukazují studie a proč je číst s rezervou
Studie SEO nástrojů a agentur měří, které weby se v odpovědích objevují, ne proč. Jsou to korelace na jejich vlastním vzorku dotazů a česká obdoba, o které bychom věděli, neexistuje.
| Kdo a kdy | Vzorek | Co našli | Jak to číst |
|---|---|---|---|
| Seer Interactive, 6. 2. 2025 | asi 100 otázek, přes 500 citací v ChatGPT | 87 % citací bylo mezi prvními 20 výsledky Bingu, u Googlu 56 % | malý vzorek a starší verze ChatGPT; naznačuje, že Bing má smysl sledovat |
| Profound, 5. 6. 2025 (aktualizace 8/2025) | 680 milionů citací, srpen 2024 až červen 2025 | ChatGPT nejčastěji cituje Wikipedii (7,8 % všech citací), AI přehledy Reddit (2,2 %) a YouTube (1,9 %), Perplexity Reddit (6,6 %) | i nejcitovanější web má pod 8 % všech citací, zbytek se rozkládá mezi mnoho dalších webů |
| Semrush, 21. 7. 2025 | 5 000 klíčových slov, přes 150 000 citací ve čtyřech AI vyhledávačích, USA | odkazy v postranním panelu Režimu AI se s první desítkou Googlu shodovaly z 51 % domén a z 32 % adres | Režim AI často sahá mimo první stránku výsledků |
| Ahrefs, 2. 3. 2026 | 863 tisíc stránek výsledků, 4 miliony adres citovaných v AI přehledech | jen 38 % citovaných stránek bylo zároveň v první desítce, v červenci 2025 (starší metodikou) asi 76 % | Ahrefs pokles vysvětluje dílčími dotazy, sám to podává jako domněnku |
Ze všech čtyř plyne podobný obraz: pozice ve výsledcích pomáhá, ale nerozhoduje sama a každý asistent má jiné oblíbené zdroje. Kolik vám dává Reddit nebo YouTube v Česku, z amerických dat nevyčtete. Že se s viditelností v AI nejvíc pojí zmínky o firmě na jiných webech, rozebírá článek zmínky o značce.
Náš test: z jakých zdrojů Gemini skládal české odpovědi
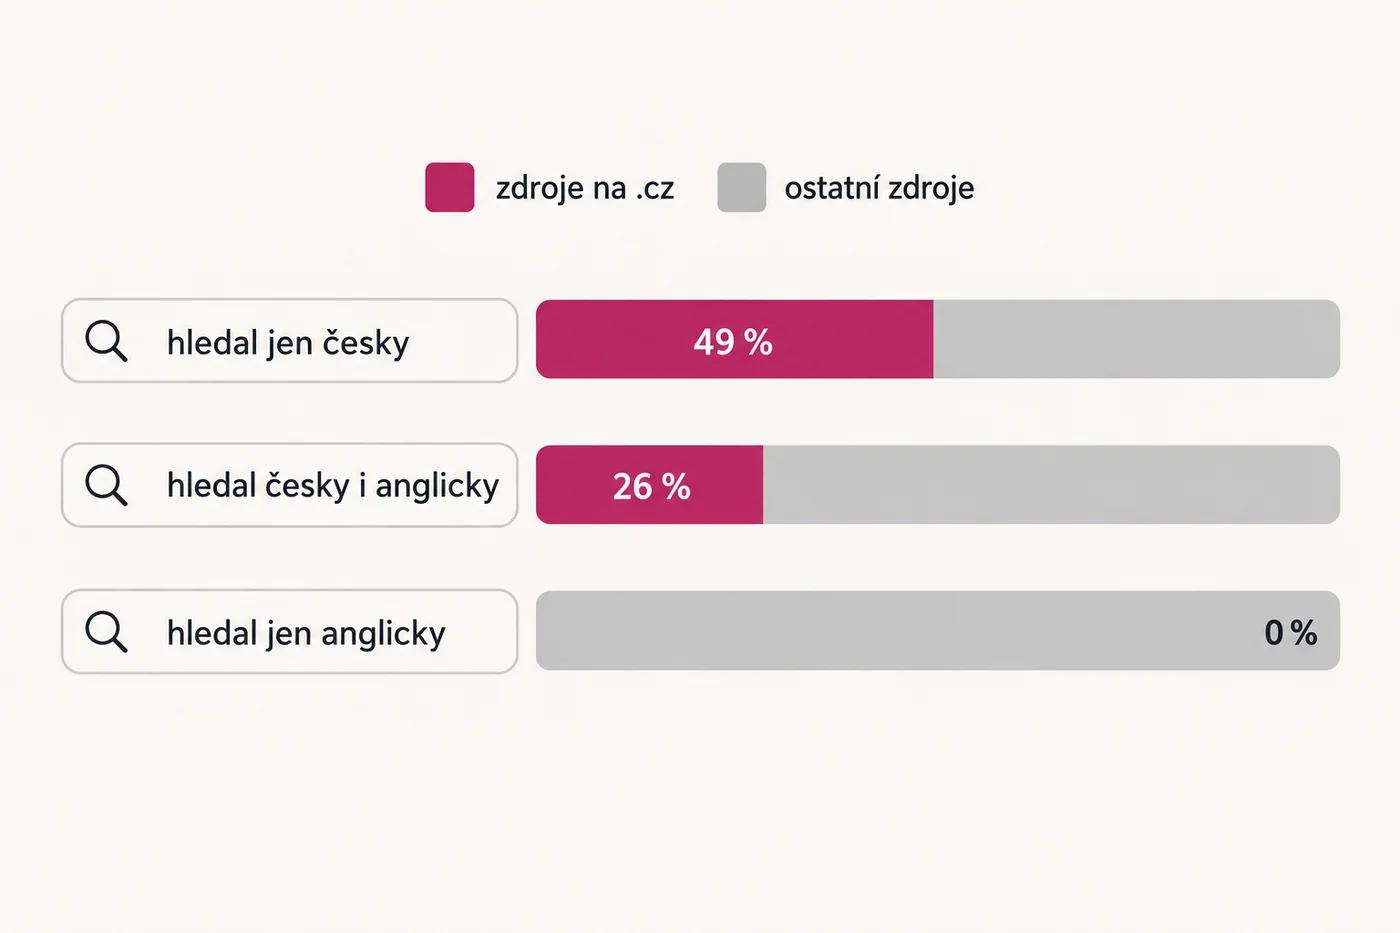
Když Gemini hledal česky, byla necelá polovina zdrojů na doméně .cz. Když hledal anglicky, nebyl mezi zdroji ani jeden web na .cz.
Test proběhl 22. 10. 2026 v Gemini API (model gemini-2.5-flash s vyhledáváním Googlu) na 25 otázkách o AI vyhledávání, které jsme sestavili podle témat, na která se ptají majitelé firem. Rozhraní u každé odpovědi vrací seznam zdrojů, ze kterých model odpověď ukotvil. V testu jsme u nich ukládali jen domény, ne konkrétní stránky. V 69 odpovědích s hledáním bylo 1 427 zdrojů z 699 různých domén. Tabulka je dělí podle toho, jakým jazykem model v dané odpovědi hledal:
| Jak Gemini v odpovědi hledal | Odpovědí | Zdrojů | Z toho na doméně .cz |
|---|---|---|---|
| jen česky | 25 | 467 | 227 (49 %) |
| česky i anglicky | 34 | 749 | 191 (26 %) |
| jen anglicky | 10 | 211 | 0 |
Nejlépe je to vidět přímo na otázce „Jak AI vyhledávače vybírají zdroje, které citují?“, kterou Gemini dostal čtyřikrát:
- Třikrát hledal česky a podle názvů domén odpověď skládal z webů českých agentur a SEO nástrojů (collabim.cz, dejtonaweb.cz, ppcprofits.cz, seoconsult.cz), univerzit a knihoven (muni.cz, cuni.cz, tul.cz, jamu.cz, techlib.cz), z aktualne.cz, businessinfo.cz, a dokonce z alza.cz. Web jamu.cz byl ve všech třech odpovědích; které jeho stránky to byly, z uložených dat nevyčteme.
- Jednou hledal anglicky (osm dotazů) a ze 35 zdrojů nebyl ani jeden český. Podle názvů domén šlo hlavně o weby marketingových agentur a firem s nástroji na SEO a AI.
V celém testu přitom tvořily domény samotných provozovatelů AI (google.com, blog.google, openai.com, perplexity.ai, microsoft.com; bez seznam.cz, který nese i zprávy a katalog) jen 40 z 1 427 zdrojů, necelá 3 %. Reddit se mezi zdroji objevil 15krát, tedy asi v 1 % případů.
Pro českou firmu z toho plynou tři věci:
- Konkurujete českým i zahraničním stránkám. I když Gemini hledal jen česky, byla na .cz zhruba polovina zdrojů, zbytek tvořily weby mimo .cz, většinou zahraniční. Mezi českými zdroji ale byly podle názvů domén i weby menších agentur, ne jen velké značky.
- Když AI přejde do angličtiny, česká stránka v tu chvíli nesoupeří. Jak často to dělají AI přehledy u českých uživatelů, Google neukazuje.
- AI odpovídá z toho, co najde, ne nutně z toho, co je nejpřesnější. Na otázku, jak vybírá zdroje, odpovídal Gemini podle názvů domén hlavně z webů agentur, ne z dokumentace Googlu. Kdo v daném jazyce na otázku srozumitelně odpoví, má šanci být citovaný, i když není největší autoritou oboru.
Meze testu: Gemini API není totéž co AI přehledy ani aplikace Gemini, gemini-2.5-flash je starší model, než jaký dnes podle Ahrefs pohání AI přehledy (Gemini 3), model měl pokyn chovat se jako vyhledávač pro uživatele v Česku a domény na .cz nezahrnují české weby na .com.
Zjistit, koho AI cituje místo vás
Co je doložené a co s tím udělat
| Co rozhoduje o citaci | Jak je to doložené | Co udělat |
|---|---|---|
| Být ve vyhledávání daného asistenta | dokumentace Googlu, OpenAI, Microsoftu, Perplexity | pustit roboty vyhledávačů a AI (Googlebot, Bingbot, OAI-SearchBot, PerplexityBot) v robots.txt i ve firewallu, ověřit web v Bing Webmaster Tools |
| Objevit se ve výsledcích na hlavní i dílčí dotazy | Google (hlavní systémy řazení, query fan-out); míru ukazují jen studie | ke každé službě odpovědět na cenu, rozsah, postup a pro koho to je |
| Pasáž, která sama odpoví na konkrétní otázku | Microsoft (dělení na části); Google dělení textu na kousky nevyžaduje | každá sekce začíná přímou odpovědí s číslem nebo příkladem |
| Jazyk, kterým AI hledá | náš test v Gemini API, 22. 10. 2026 | psát česky a českými výrazy, které používají zákazníci |
| Zmínky o firmě na jiných webech | korelace ve studiích; Google varuje, že falešné zmínky nepomáhají | pravdivé a stejné údaje o firmě v katalozích, recenzích a médiích |
| llms.txt a speciální schéma pro AI | Google: Vyhledávání je nepoužívá | do AI odpovědí vás samy nedostanou |
Celý postup od webu po měření popisuje průvodce GEO optimalizace pro AI vyhledávače (GEO tu znamená optimalizaci pro AI odpovědi, ne geografii).
