Když do Googlu zadáte dotaz, Google v tu chvíli neprohledává internet. Prohledává vlastní kopii internetu, kterou si průběžně staví. A o tom, jestli v ní váš web je, se rozhodlo dávno předtím, než zákazník začal psát. Věta „nejsme na Googlu vidět" proto může znamenat tři úplně různé problémy: Google web nenašel, našel ho a nepustil dál, nebo ho zná a jen ho řadí hluboko. Každý se opravuje jinak a v Search Console se dá zadarmo poznat, který z nich máte.
Google sám svůj postup popisuje jako tři fáze: procházení, indexaci a řazení výsledků. A hned v úvodu dokumentace stojí věta, kterou by si měl přečíst každý, komu někdo slibuje zázraky: Google nepřijímá platby za to, že web projde častěji nebo ho zařadí výš. Kdo tvrdí opak, nemá pravdu, tohle není můj názor, to je doslovná citace.
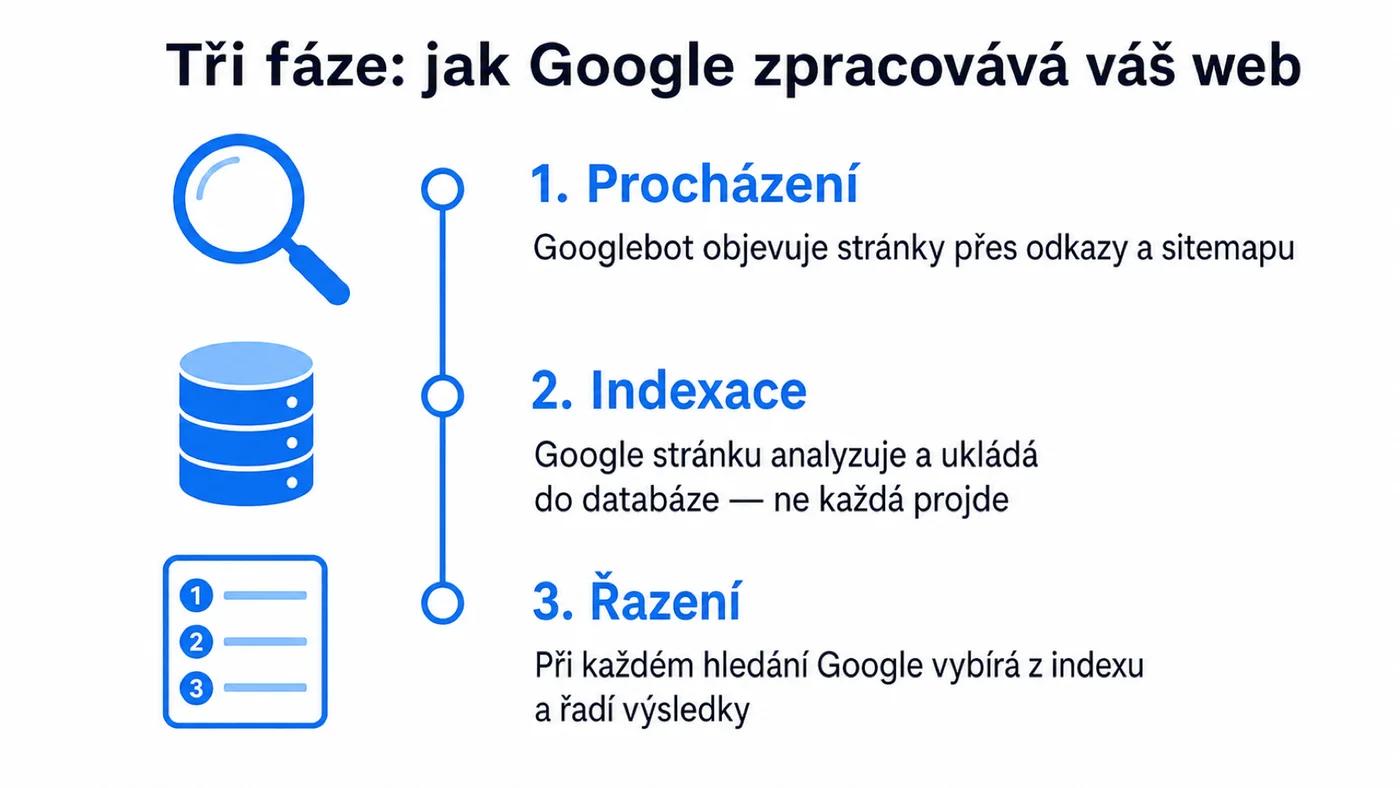
Fáze 1: Procházení, Google musí váš web nejdřív najít
Internet nemá žádný centrální seznam stránek. Google si ho staví sám: program jménem Googlebot chodí po stránkách, které už zná, sbírá z nich odkazy na další adresy a ty si přidává do fronty. Z toho plyne věc, kterou majitelé nových webů zjišťují bolestně: stránka, na kterou nevede žádný odkaz, pro Google prakticky neexistuje.
Přivést Googlebota můžete dvěma cestami: odkazy (interními i z cizích webů) a sitemapou, tedy seznamem adres, který mu předáte přímo.
Kolik stránek a jak často Googlebot z webu stáhne, si rozhoduje sám (říká se tomu rozpočet procházení). Řídí se mimo jiné tím, jak server odpovídá: když zpomaluje nebo vrací chyby, Googlebot ubere, aby web nepoložil. U firemního webu o padesáti stránkách tohle řešit nemusíte; hrát roli začíná u e-shopů a portálů s tisíci adres, kde se Googlebot ke vzdálenějším stránkám dostává pomalu.
Jedna technická věc, která rozhoduje víc, než se zdá: Google stránku při procházení vykresluje podobně jako prohlížeč, včetně spuštění JavaScriptu (používá na to aktuální verzi Chromu). Web, který skládá obsah JavaScriptem, tedy přečíst umí, jen později a ne vždy celý.
A co procházení nejčastěji zablokuje? Zákaz v souboru robots.txt (klasika je pravidlo zakazující celý web, zapomenuté z vývoje), padající server a stránky schované za přihlášením.
Fáze 2: Indexace, do indexu se nedostane všechno
Prošlou stránku se Google snaží pochopit: analyzuje text, nadpisy, obrázky i videa. Zjišťuje, jestli není kopií něčeho, co už zná: podobné stránky si seskupí a vybere z nich jednu reprezentativní, kterou pak ukazuje ve výsledcích. Teprve potom stránku uloží do indexu, databáze rozložené na tisících počítačů, ve které leží stovky miliard stránek.
Podstatné je to „teprve". Google v dokumentaci píše výslovně, že indexace není zaručená: ne každá zpracovaná stránka se do indexu dostane. Venku nejčastěji zůstávají tenké stránky bez vlastního obsahu, duplicity a stránky, které si web sám zakázal metaznačkou noindex (kdy se hodí a kdy škodí, popisuju v článku o noindexu).
V Search Console o téhle fázi vyprávějí dvě hlášky, které se pletou, a přitom znamenají opak:
- Objeveno - momentálně neindexováno. Google o stránce ví, ale ještě na ní nebyl. To je ve skutečnosti problém fáze 1: stránka čeká ve frontě na procházení.
- Procházeno - momentálně neindexováno. Google na stránce byl a rozhodl se ji zatím do indexu nepustit. Nápověda suše dodává, že v budoucnu indexována být může, ale nemusí, a že znovu odesílat adresu nemá smysl. Tady pomáhá jediné: zlepšit obsah, sloučit duplicity a posílit interní odkazy na stránku.
Rychlý test, jestli vás Google vůbec zná: zadejte do vyhledávání site:vasedomena.cz. Je to jen hrubý odhad (přesná čísla najdete v Search Console v přehledu Stránky), ale když vypadne prázdno, máte jasno.
Většina webů, které mi projdou rukama, ztrácí návštěvnost kvůli třem až pěti chybám. Které brzdí ten váš? Pošlete mi adresu a do 48 hodin to víte. Ručně, zdarma a bez závazku.
Fáze 3: Řazení, hraje se znovu při každém hledání
První dvě fáze běží průběžně na pozadí. Třetí se odehrává v okamžiku, kdy někdo něco hledá. Google si nejdřív přeloží dotaz: opraví překlepy, pozná synonyma a hlavně odhadne záměr. Kdo píše „matrace 90×200 cena", chce nakupovat; kdo píše „jak vybrat matraci", chce číst. Pak z indexu vytáhne stránky, které odpovídají, a seřadí je.
Podle čeho přesně, Google neprozrazuje. Popisuje ale kategorie signálů a ty k pochopení hry stačí:
- Relevance. Odpovídá stránka na to, co člověk hledá? Nerozhoduje počet opakování hledaného slova, ale jestli stránka téma skutečně pokrývá.
- Kvalita a důvěryhodnost. Působí zdroj jako někdo, kdo tématu rozumí? Jedním ze signálů jsou odkazy z jiných respektovaných webů.
- Použitelnost. Načítá se stránka rychle a funguje na mobilu? Při jinak srovnatelném obsahu vyhrává ta pohodlnější. Co přesně Google měří, rozebírám u Core Web Vitals.
- Kontext hledajícího. Jazyk, poloha, zařízení. „Pizza" vrátí v Brně jiné výsledky než v Praze, a je to tak správně.
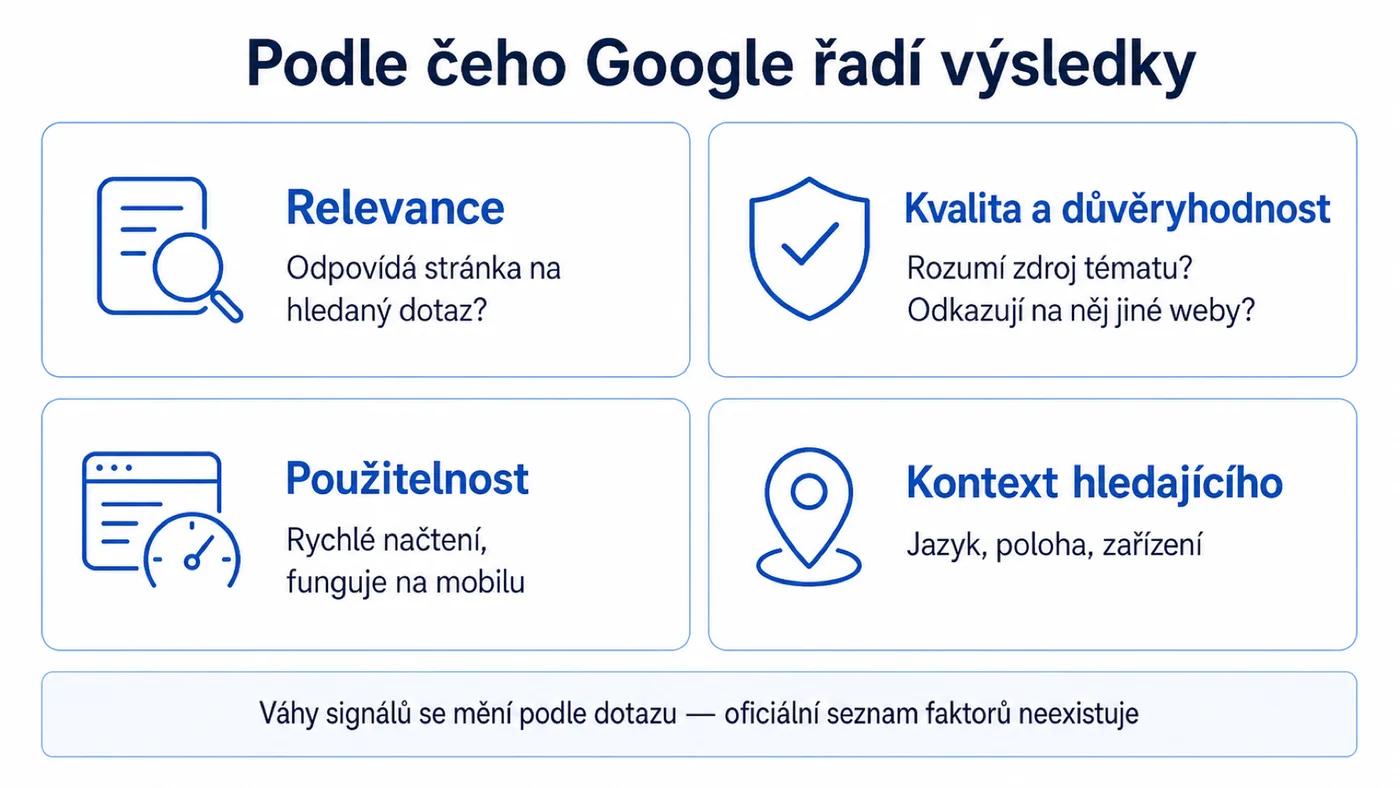
Váhy signálů nejsou pevné: u zpráv rozhoduje čerstvost, u kuchařských receptů skoro vůbec. A tady stojí za to zabít jeden mýtus. Seznamy „200 ranking faktorů", které kolují internetem, nepocházejí od Googlu. Žádný oficiální seznam nikdy nevyšel. Google mluví o stovkách signálů s proměnlivou vahou a víc neřekne; všechny tabulky faktorů, které najdete, jsou odhady třetích stran. Některé trefné, jiné vymyšlené, a zvenku se to nepozná.
Rok 2026: nad výsledky přibyla vrstva AI
Tři fáze zůstávají, ale stránka s výsledky vypadá jinak než před pár lety. U části dotazů se nahoře zobrazují Přehledy od AI (AI Overviews): vygenerovaná odpověď s odkazy na zdroje, v Česku od května 2025. Od října 2025 je u nás navíc Režim AI, samostatná záložka, kde celou stránku tvoří konverzační odpověď. Prakticky to znamená, že u informačních dotazů část lidí dostane odpověď bez jediného kliknutí a soutěží se o to, koho AI odpověď cituje.
Pro pochopení Googlu je podstatná jedna souvislost: AI vrstva staví na stejném indexu. Stránka, která neprojde procházením a indexací, se neobjeví v klasických výsledcích ani v AI odpovědi. Základy se nemění, jen laťka toho, co stojí za citování, jde nahoru. Co přesně se ve výsledcích změnilo a jak na to reagovat, píšu v článku o AI Overviews a Režimu AI.
Diagnóza: ve které fázi váš web ztrácí
K čemu je to celé dobré: mlhavý pocit „nejsme vidět" se dá v Search Console rozložit na konkrétní fázi a konkrétní první krok.
Search Console je zdarma a založíte ji za pár minut. Pokud v ní děláte první kroky, provede vás můj velký návod pro majitele firem; hlouběji do potíží s indexací jde článek o crawlování a indexaci.
Časté otázky
Za jak dlouho se nová stránka objeví v Googlu?
U zavedeného webu obvykle za dny až týdny, u zbrusu nového i déle: Google ho musí nejdřív objevit a začít mu věřit. Posun v pozicích je pak běh na měsíce: u klientů se první měřitelný pohyb v Search Console ukazuje typicky za 2 až 4 měsíce.
Jak Google popostrčím, aby stránku zaindexoval rychleji?
V Search Console vložte adresu do pole Kontrola adresy URL a klikněte na Požádat o indexaci. Funguje to pro jednotlivé důležité stránky (nová služba, zásadní článek), ne jako hromadné řešení. A pomáhá jen s procházením: když Google stránku prošel a indexovat ji nechce, opakované žádosti nic nezmění.
Proč je konkurence výš, i když má horší web?
„Horší" v očích návštěvníka většinou znamená vzhled. Jenže ten Google skoro nehodnotí. Konkurent má nejspíš víc odkazů z jiných webů, delší historii nebo obsah, který lépe sedí na hledané dotazy. Design rozhoduje až u člověka, který na stránce přistane; o pořadí rozhodují signály, které zvenku nejsou vidět.
Nechcete to řešit sami? Pošlete mi adresu webu - do 48 hodin víte, co ho v Googlu brzdí.
Tři síta, tři různé opravy
Nejdražší chyba, kterou u webů vídám: majitel tuší, že „není vidět", a opravuje naslepo. Píše nové texty, i když web vázne v procházení, nebo shání odkazy, i když polovina stránek vůbec není v indexu. Půl roku práce pak vylepšuje fázi, ve které problém nebyl. Diagnóza přitom stojí půl hodiny v Search Console.
Audit, kterým u mě spolupráce začíná, je přesně tahle diagnóza: kolik stránek z vašeho webu Google zná, kolik jich pustil do indexu a proč ostatní nechal venku. Je zdarma a teprve po něm má smysl cokoliv opravovat.
Zdroje k faktům v článku:
- Tři fáze vyhledávání, Googlebot a rozpočet procházení, vykreslování JavaScriptu v Chromu, „indexace není zaručená", index na tisících počítačů, žádné platby za procházení ani pozice (ověřeno 16. 7. 2026): developers.google.com/search/docs/fundamentals/how-search-works
- Signály řazení (význam dotazu, relevance, kvalita, použitelnost, kontext), proměnlivé váhy podle dotazu, stovky miliard stránek (ověřeno 16. 7. 2026): google.com/search/howsearchworks
- Stavy „Objeveno/Procházeno - momentálně neindexováno" v přehledu Stránky (ověřeno 16. 7. 2026): support.google.com/webmasters/answer/7440203
- Spuštění Přehledů od AI v Česku, 20. 5. 2025 (ověřeno 16. 7. 2026): blog.google, Google spouští v Česku Přehledy od AI; spuštění Režimu AI v Česku, 7. 10. 2025 (ověřeno 16. 7. 2026): blog.google, Režim AI přichází do Česka
